DOE(実験計画)は、ふつうシステムから新しいデータを集めるために使います。一方で、必要なデータがすでに十分集まっていることも少なくありません。そうしたデータは長い期間にわたって蓄積されたものが多く、量が多すぎて、そのままでは解析が現実的でないこともあります。たとえば、実際に使われている部品にセンサーを付けて健全性を監視する場合、そのデータは部品の運用期間全体にわたって連続的に記録されることがあります。SmartUQのデータサンプリングツールは、こうしたデータを、空間充填DOEのように配置された部分集合に分けられます。データを集める前に作るDOEとは違い、サブサンプリングやスライスサンプリングといったデータサンプリングでは、既存の入力と出力のデータの組から、設計空間をうまく代表する点を選び出します。
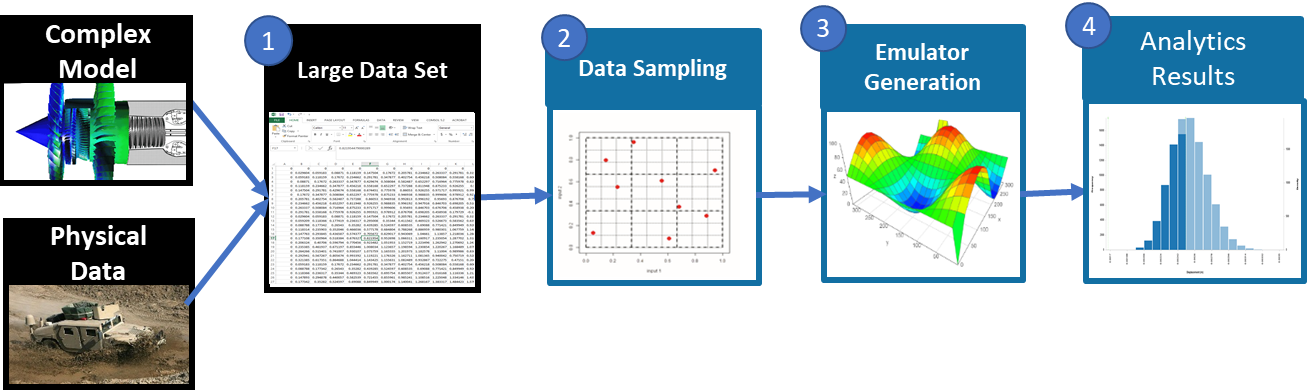 データサンプリングのワークフロー
サブサンプリングのアルゴリズムは、既存の大きなデータから、ユーザーが指定した数の点を抜き出し、元のデータを十分に代表させます。データを機械的に2つに分けるのとは違い、サブサンプリングツールは空間充填DOEのようになる点を選ぶので、抜き出したデータの偏りを抑えられます。元のデータの一部だけを使うので計算負荷は大きく下がり、しかも点を賢く選ぶことで、高度な解析の精度は保たれます。残った大きいほうのデータはモデルの妥当性確認に使えるので、シミュレーションや試験のリソースを節約しながら、予測精度にも確信を持てます。
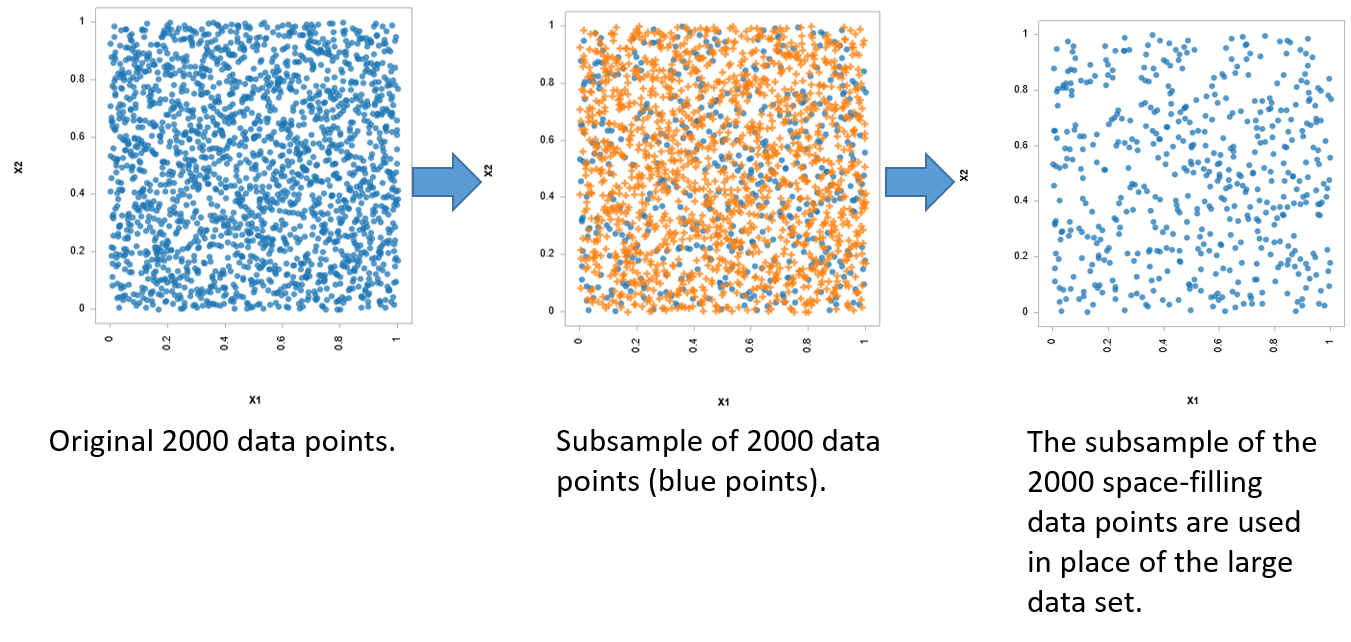 サブサンプリングの処理
スライスDOEと同じように、スライスサンプリングのアルゴリズムはデータをいくつかのグループに分けます。ただし、元のデータが空間充填DOEになっていることは前提にしません。それぞれのスライスは、エミュレーター(サロゲートモデル)の構築や、モデルの妥当性確認に使えます。
スライス構造によって可能になる独自のエミュレーション手法が、分割・統合(divide and combine)法です。学習に使うスライスごとにエミュレーターを作り、それらをすべて統合して、最終結果のための1つのエミュレーター(サロゲートモデル)にします。これにより並列計算ができるようになり、大規模なデータの高度な解析に必要なメモリも減らせます。
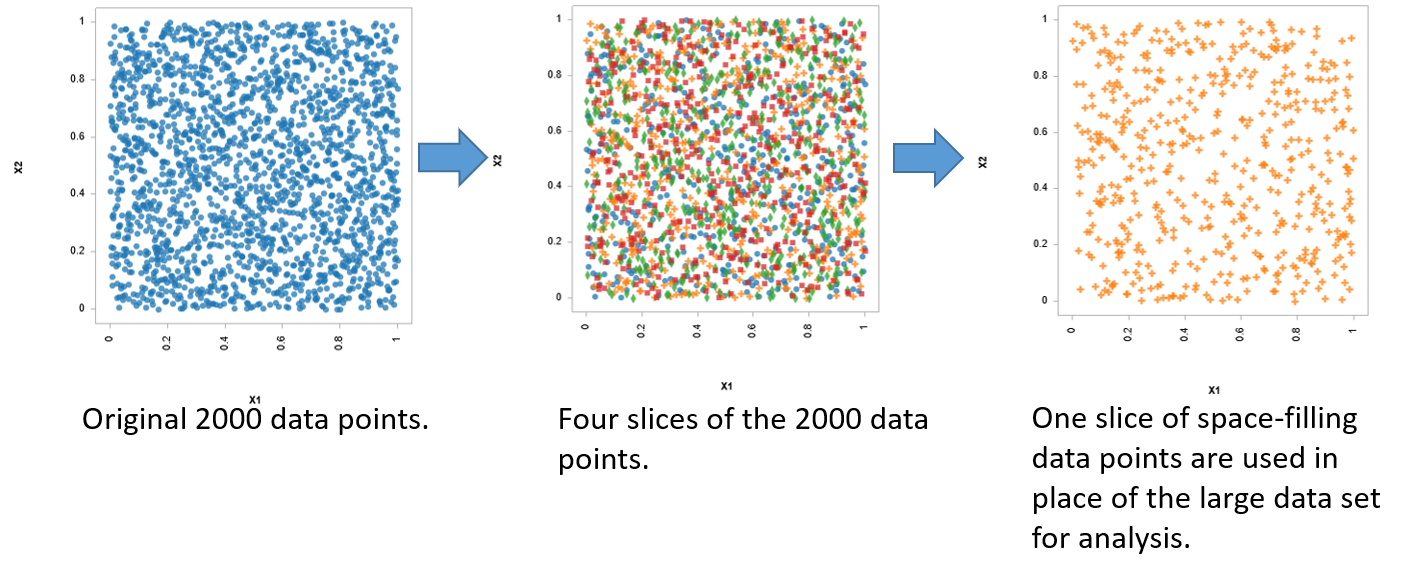 スライスサンプリングの処理